Esta página junta en una sola vista los resultados por unidad de los cinco flujos: sismo, incendio forestal, movimientos en masa, incendio urbano y calor. Responde a una pregunta de priorización: ¿qué manzanas aparecen una y otra vez entre las más expuestas, y cuáles lo son por una sola amenaza? Es el paso de síntesis que el manual CLIMAAX ubica tras evaluar cada amenaza, cuando hay que decidir cuáles riesgos son clave CLIMAAX consortium, 2026.
Qué análisis están disponibles
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from IPython.display import Markdown, display

from sidro import process, viz
from sidro.analisis import indices, sintesis
from sidro.config import rutas

df, claves, faltan = sintesis.cargar()
if df is None:
    display(Markdown(":::{warning}\nNo hay resultados en `data/processed/`. Ejecute primero los cuadernos "
                     "`c_riesgo` de 3.1 a 3.5 (cada uno guarda `riesgo_<amenaza>.parquet`).\n:::"))
else:
    estado = pd.DataFrame({
        "amenaza": [sintesis.AMENAZAS[k][0] for k in sintesis.AMENAZAS],
        "métrica de `riesgo`": [sintesis.AMENAZAS[k][1] for k in sintesis.AMENAZAS],
        "disponible": ["sí" if k in claves else "no" for k in sintesis.AMENAZAS],
    })
    display(estado)
    if len(claves) < 2:
        display(Markdown(":::{note}\nCon una sola amenaza no hay nada que combinar; la síntesis se completa al "
                         "ejecutar al menos dos análisis.\n:::"))
df = NoneRiesgos normalizados
if df is not None:
    n = sintesis.normalizar_riesgos(df, claves)
    df = df.join(n)
    df["riesgo_combinado"] = sintesis.combinar(df, claves)
    nombres = {f"n_{k}": sintesis.AMENAZAS[k][0] for k in claves}
    tabla = df[["id_unidad", "riesgo_combinado", *nombres]].rename(columns=nombres)
    print(f"{len(df)} unidades; amenazas combinadas: {', '.join(sintesis.AMENAZAS[k][0] for k in claves)}")
    display(tabla.sort_values("riesgo_combinado", ascending=False).head(10).round(2))
57 unidades; amenazas combinadas: Sismo, Incendio forestal, Movimientos en masa, Incendio urbano, Calor
El riesgo combinado es el promedio simple de los riesgos normalizados disponibles en cada unidad (todas las amenazas pesan igual). Si a una unidad le falta el dato de una amenaza, el promedio se calcula con las demás. Dar pesos distintos es una decisión de política —por ejemplo, ponderar más la amenaza que causa más víctimas— y debe tomarse y justificarse con las autoridades locales; aquí no se hace.
if df is not None:
    m = viz.mapa_base()
    viz.capa(m, df, "riesgo_combinado", nombre="Riesgo combinado (0–1)", cmap="YlOrRd",
             tooltip=["id_unidad", "riesgo_combinado", *[f"n_{k}" for k in claves]])
    viz.cerrar(m)
else:
    m = None
mEn cuántas amenazas es alta cada manzana
Cada riesgo se clasifica en terciles (baja, media, alta) por separado y se cuenta en cuántos de ellos la manzana queda en el tercil alto. Una manzana alta en tres o más amenazas es un caso de riesgo múltiple; una alta en una sola es un problema específico que pide una medida específica.
if df is not None:
    clases = sintesis.conteo_clase_alta(df, claves)
    df = df.join(clases)
    resumen = df["n_altas"].value_counts().sort_index().rename("manzanas").to_frame()
    resumen.index.name = "amenazas en clase alta"
    display(resumen)
    m = viz.mapa_base()
    viz.capa(m, df, "n_altas", nombre="Amenazas en clase alta", cmap="Reds", categorica=True,
             tooltip=["id_unidad", "n_altas", "riesgo_combinado"])
    viz.cerrar(m)
else:
    m = None
mif df is not None:
amenazas_alta = (clases[[f"clase_{k}" for k in claves]] == 2).sum().rename(
index={f"clase_{k}": sintesis.AMENAZAS[k][0] for k in claves})
display(amenazas_alta.rename("manzanas en clase alta").to_frame())Los terciles reparten las manzanas en tres grupos de tamaño parecido, así que cada amenaza tendrá aproximadamente un tercio de sus unidades en clase alta; lo informativo es el solapamiento entre amenazas, no el número por amenaza. Cuando hay muchos empates (por ejemplo, ninguna persona en amenaza alta en casi todas las manzanas), el tercil alto es poco fiable: revise la tabla del flujo.
Perfil de las manzanas más expuestas
if df is not None and len(claves) >= 3:
    top = df.sort_values("riesgo_combinado", ascending=False).head(5)
    ang = np.linspace(0, 2 * np.pi, len(claves), endpoint=False).tolist()
    ang += ang[:1]
    fig, ax = plt.subplots(subplot_kw={"projection": "polar"}, figsize=(5.2, 5.2))
    for _, fila in top.iterrows():
        v = [0.0 if pd.isna(fila[f"n_{k}"]) else fila[f"n_{k}"] for k in claves]
        ax.plot(ang, [*v, v[0]], label=fila["id_unidad"], lw=1.5)
        ax.fill(ang, [*v, v[0]], alpha=0.08)
    ax.set_xticks(ang[:-1], [sintesis.AMENAZAS[k][0] for k in claves], fontsize=8)
    ax.set_ylim(0, 1), ax.set_yticks([0.25, 0.5, 0.75, 1.0]), ax.legend(loc="upper right", bbox_to_anchor=(1.3, 1.1), fontsize=8)
    fig
elif df is not None:
    display(Markdown("El gráfico de perfil necesita al menos tres amenazas disponibles."))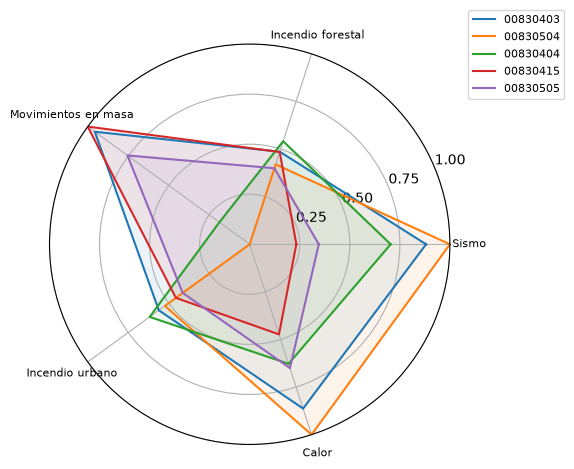
El perfil muestra, para las cinco manzanas con mayor riesgo combinado, qué amenazas la explican. Una forma alargada hacia un solo vértice indica que una amenaza domina; una forma amplia indica riesgo múltiple. Una amenaza sin dato en la unidad se dibuja en cero, lo que no quiere decir que sea baja.
Riesgo combinado × vulnerabilidad social
if df is not None:
    biv = indices.bivariado(df["riesgo_combinado"], df["vulnerabilidad_social"])
    df = df.join(biv)
    m = viz.mapa_base()
    viz.capa_bivariada(m, df)
    viz.cerrar(m)
else:
    m = None
m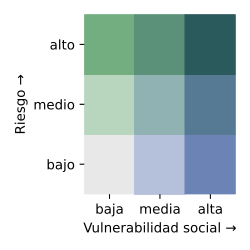
Leyenda: riesgo combinado en el eje vertical, vulnerabilidad social en el horizontal.
La vulnerabilidad social es el promedio de la calculada en los flujos 3.1 a 3.4 (en 3.5 se usa la vulnerabilidad específica al calor, que no entra aquí). Si salió vacía, aún no se cargaron los datos censales de 2.2 y todas las manzanas caen en la misma columna del mapa bivariado: en ese caso el mapa solo ordena por riesgo.
Exportación
if df is not None:
    cols = ["id_unidad", "geometry", "riesgo_combinado", "n_altas", "vulnerabilidad_social",
            *[f"n_{k}" for k in claves], "bivariado"]
    salida = process.guardar(df[cols], "riesgo_multiamenaza")
    print("Guardado:", salida.relative_to(rutas().raiz))
    from sidro import export

    export.guardar_resumen("sintesis_multiamenaza", {
        "amenazas": claves, "faltantes": faltan, "unidades": len(df),
        "manzanas_por_amenazas_altas": {int(k): int(v) for k, v in df["n_altas"].value_counts().sort_index().items()}})
Guardado: data/processed/riesgo_multiamenaza.parquet
Del análisis a la decisión
La síntesis sirve para tres usos, y cada uno exige cautelas distintas:
Priorizar dónde mirar primero. Las manzanas con riesgo combinado alto o con varias amenazas en clase alta son las candidatas a estudios de detalle, inspección o visitas de campo. No son una lista de intervenciones.
Elegir el tipo de medida. El perfil indica si el problema es una amenaza dominante (por ejemplo, una ladera) o un riesgo múltiple que justifica una medida integrada.
Comunicar el riesgo. El conocimiento del riesgo incluye su comunicación a la población Congreso de la República de Colombia, 2012: los mapas de esta página están pensados para una conversación con la comunidad, explicando siempre que son relativos al barrio y que dependen de datos y supuestos que se pueden mejorar.
Antes de usar estos resultados fuera del libro hay que sustituir los valores ilustrativos de
config/parametros.yaml, incorporar los datos censales y catastrales que faltan y someter el análisis
a revisión técnica de IDIGER.
- CLIMAAX consortium. (2026). CLIMAAX Climate Risk Assessment Handbook. Zenodo. 10.5281/zenodo.18186357
- Congreso de la República de Colombia. (2012). Ley 1523 de 2012, por la cual se adopta la política nacional de gestión del riesgo de desastres y se establece el Sistema Nacional de Gestión del Riesgo de Desastres. http://www.secretariasenado.gov.co/senado/basedoc/ley_1523_2012.html